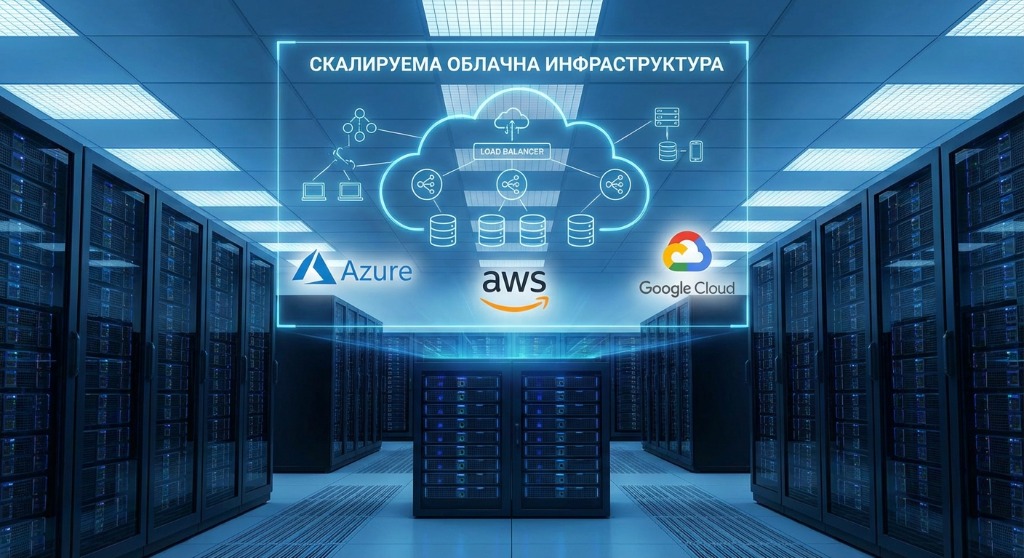
Cloud платформа в Azure / AWS / Google CloudSaaS платформа / уеб услугаМалък инженеринг/DevOps екип
Cloud платформа в Azure / AWS / Google Cloud
Екип поддържаше платформа с ръчни разгръщания и различни среди, което водеше до риск при промени и затруднено възстановяване при инциденти. Мигрирахме платформата към cloud с инфраструктура като код, наблюдаемост и SLO подход.
99.9%
Примерна availability SLO цел (месец) в SRE практики
24 ч
Lead time за промяна при elite performers (DORA бенчмарк)
Цели на проекта
1
Стандартизирани среди чрез инфраструктура като код (IaC)
2
По-бързи и по-безрискови деплои
3
Наблюдаемост (logs/metrics/traces) и ясни SLO цели
4
По-бързо възстановяване при инциденти
Нашият подход
1
Дефиниране на целевата архитектура и разделяне на платформата на ясно отговорни компоненти.
2
Внедряване на IaC за среди и конфигурации и автоматизиране на деплоя.
3
Добавяне на мониторинг, алерти и incident runbooks.
4
Въведено SLO/SLI метрики и error budget подход за баланс между промени и надеждност.
Решение
- Cloud инфраструктура, описана като код (IaC).
- CI/CD за разгръщания с контролни проверки.
- Observability stack (metrics/logs/traces) и алерти.
- SLO рамка и процес за инциденти.
Резултати
- По-стандартизирани среди и по-предвидими разгръщания.
- По-добра видимост върху системата и по-бърза диагностика.
- По-ясни цели за надеждност (SLO) и управление на промени чрез error budgets.
FAQ
Трябва ли да мигрираме всичко наведнъж?
Не. Най-често миграцията е поетапна – започва се с критичните компоненти и се валидира стабилността.
Как измерваме надеждност?
Чрез SLI метрики (availability/latency/error rate) и SLO цели, плюс error budgets за контрол на риска.
Какво става при инцидент?
Има алерти, runbooks и процес за реакция/постмортем, за да се намали MTTR и да се предотврати повторение.
Контакт
Имате въпрос или искате да обсъдим проект? Пишете ни.